Domain gruppierung.de kaufen?
Wir ziehen mit dem Projekt
gruppierung.de um.
Sind Sie am Kauf der Domain
gruppierung.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain gruppierung.de kaufen?
Wie kann Textklassifikation in verschiedenen Bereichen wie der Sprachverarbeitung, der Informationsextraktion und der automatischen Kategorisierung von Dokumenten eingesetzt werden?
Textklassifikation kann in der Sprachverarbeitung eingesetzt werden, um Texte nach Themen oder Stimmungen zu kategorisieren, was bei der Analyse von Kundenfeedback oder sozialen Medien hilfreich ist. In der Informationsextraktion kann Textklassifikation verwendet werden, um relevante Informationen aus unstrukturierten Texten zu extrahieren, beispielsweise um wichtige Daten aus medizinischen Berichten zu identifizieren. Bei der automatischen Kategorisierung von Dokumenten kann Textklassifikation helfen, große Mengen von Dokumenten zu organisieren und zu kategorisieren, was die Suche und den Zugriff auf relevante Informationen erleichtert. Insgesamt kann Textklassifikation in verschiedenen Bereichen dazu beitragen, Texte effizient zu analysieren und zu strukturieren, um nützliche Informationen zu gewinnen. **
Wie kann Textklassifikation in verschiedenen Bereichen wie der Sprachverarbeitung, der Informationsextraktion und der automatischen Kategorisierung von Dokumenten eingesetzt werden?
Textklassifikation kann in der Sprachverarbeitung eingesetzt werden, um automatisch Texte in verschiedene Kategorien zu klassifizieren, wie z.B. Nachrichten, E-Mails oder soziale Medien. In der Informationsextraktion kann Textklassifikation verwendet werden, um relevante Informationen aus unstrukturierten Texten zu extrahieren, wie z.B. Namen, Orte oder Termine. In der automatischen Kategorisierung von Dokumenten kann Textklassifikation helfen, große Mengen von Dokumenten automatisch in verschiedene Kategorien zu sortieren, was die Suche und Organisation von Informationen erleichtert. Durch den Einsatz von Textklassifikationstechniken können Unternehmen und Organisationen effizienter arbeiten und wertvolle Erkenntnisse aus unstrukturierten Textdaten gewinnen. **

Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Erzi Sortierung VeggieburgerUnser Veggieburger ist ein Hamburger, der ganz ohne Fleisch auskommt. Das Patty besteht aus pflanzlichen und veganen Fleischersatzprodukten und Gemüse. Das Brötchen wird nach Belieben mit Salat, Patty, Avocadoscheiben und Tomaten belegt. Hinzu die herzhafte Soße und leckere Süßkartoffelpommes. 16 Teile aus Holz: 1 Servierbrettchen, 2 halbe Brötchenteile, 1 veganes Patty, 1 Salatblatt, 1 Tomatenscheibe, 2 Avocadoscheiben, 8 Süßkartoffelpommes, 1 Soßenflasche Material: Buche, farbig lackiert und bedruckt; Sperrholz Birke, bedruckt17,99 €*Versand: 5,49 €Sichere Weiterleitung zum Anbieter

-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **

Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
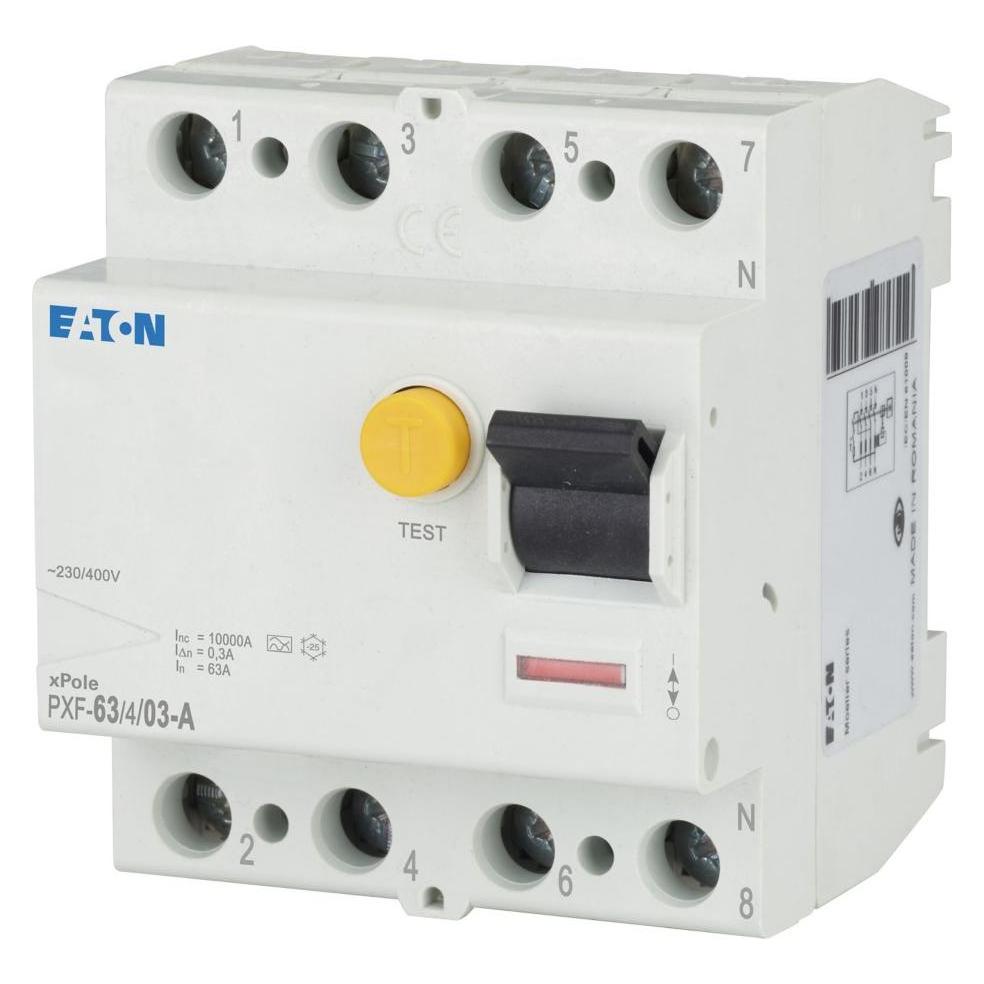
Eaton, Schutzschalter, Sicherungstyp (Kategorisierung)Der Eaton PXF-40/4/03-A ist ein kompakter Fehlerstromschutzschalter, der für eine Vielzahl von Anwendungen geeignet ist. Mit einer Nennstromstärke von 40 A und einer Nennspannung von 400 V bietet dieser 4-polige Schutzschalter eine zuverlässige Lösung zum Schutz von elektrischen Anlagen vor Fehlerströmen. Die Schaltleistung von 10 kA gewährleistet eine hohe Sicherheit, während die Schutzart IP20 den Einsatz in weniger anspruchsvollen Umgebungen ermöglicht. Der Schalter ist für den Einsatz auf Hutschienen konzipiert und kann in verschiedenen Installationen verwendet werden. Die Betriebsbedingungen sind für Temperaturen zwischen -25 °C und 60 °C ausgelegt, was eine flexible Nutzung in unterschiedlichen Umgebungen ermöglicht. Der Eaton PXF-40/4/03-A ist somit eine robuste und vielseitige Wahl für den Schutz elektrischer Systeme. - Fehlerstromschutzschalter mit einer Nennstromstärke von 40 A - Schaltleistung von 10 kA für hohe Sicherheit - Geeignet für Temperaturen von -25 °C bis 60 °C - Montage auf Hutschiene für einfache Installation - Schutzart IP20 für den Einsatz in weniger anspruchsvollen Umgebungen.54,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann Textklassifikation in verschiedenen Bereichen wie der Sprachverarbeitung, der Informationsextraktion und der automatischen Kategorisierung von Dokumenten eingesetzt werden?
Textklassifikation kann in der Sprachverarbeitung eingesetzt werden, um Texte nach Themen oder Stimmungen zu kategorisieren, was bei der Analyse von Kundenfeedback oder sozialen Medien hilfreich ist. In der Informationsextraktion kann Textklassifikation verwendet werden, um relevante Informationen aus unstrukturierten Texten zu extrahieren, beispielsweise um wichtige Daten aus medizinischen Berichten zu identifizieren. Bei der automatischen Kategorisierung von Dokumenten kann Textklassifikation helfen, große Mengen von Dokumenten zu organisieren und zu kategorisieren, was die Suche und den Zugriff auf relevante Informationen erleichtert. Insgesamt kann Textklassifikation in verschiedenen Bereichen dazu beitragen, Texte effizient zu analysieren und zu strukturieren, um nützliche Informationen zu gewinnen. **
-
Wie kann Textklassifikation in verschiedenen Bereichen wie der Sprachverarbeitung, der Informationsextraktion und der automatischen Kategorisierung von Dokumenten eingesetzt werden?
Textklassifikation kann in der Sprachverarbeitung eingesetzt werden, um automatisch Texte in verschiedene Kategorien zu klassifizieren, wie z.B. Nachrichten, E-Mails oder soziale Medien. In der Informationsextraktion kann Textklassifikation verwendet werden, um relevante Informationen aus unstrukturierten Texten zu extrahieren, wie z.B. Namen, Orte oder Termine. In der automatischen Kategorisierung von Dokumenten kann Textklassifikation helfen, große Mengen von Dokumenten automatisch in verschiedene Kategorien zu sortieren, was die Suche und Organisation von Informationen erleichtert. Durch den Einsatz von Textklassifikationstechniken können Unternehmen und Organisationen effizienter arbeiten und wertvolle Erkenntnisse aus unstrukturierten Textdaten gewinnen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Erzi Sortierung VeggieburgerUnser Veggieburger ist ein Hamburger, der ganz ohne Fleisch auskommt. Das Patty besteht aus pflanzlichen und veganen Fleischersatzprodukten und Gemüse. Das Brötchen wird nach Belieben mit Salat, Patty, Avocadoscheiben und Tomaten belegt. Hinzu die herzhafte Soße und leckere Süßkartoffelpommes. 16 Teile aus Holz: 1 Servierbrettchen, 2 halbe Brötchenteile, 1 veganes Patty, 1 Salatblatt, 1 Tomatenscheibe, 2 Avocadoscheiben, 8 Süßkartoffelpommes, 1 Soßenflasche Material: Buche, farbig lackiert und bedruckt; Sperrholz Birke, bedruckt17,99 €*Versand: 5,49 €Sichere Weiterleitung zum Anbieter
-
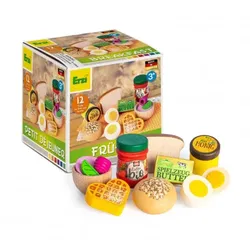
Erzi Sortierung Frühstück11 Teile aus Holz: 1 Körnerbrötchen, 1 Toastbrotscheibe, 1 Waffelherz, 1 Butter, 1 Erdbeermarmelade von Schwartau, 1 Honig, 2 halbe Eier zum Schneiden, 1 Tasse mit Früchtetee, 1 Himbeere, 1 Minzblatt Material: Buche, farbig lackiert und bedruckt17,99 €*Versand: 5,49 €Sichere Weiterleitung zum Anbieter
-
Greene, Liz: Abwehr und Abgrenzung als positive Dimension des Lebens und ihre Entsprechungen im HoroskopAbwehr und Abgrenzung als positive Dimension des Lebens und ihre Entsprechungen im Horoskop , Als positive Dimension des Lebens und ihre Entsprechungen im Horoskop , Öltanks > Motoren & Motorteile , Erscheinungsjahr: 199701, Produktform: Kartoniert, Titel der Reihe: Standardwerke der Astrologie##, Autoren: Greene, Liz, Übersetzung: Köhler, Klaus, Seitenzahl/Blattzahl: 314, Abbildungen: 4 Abbildungen, Fachschema: Astrologie~Astrologie / Horoskop~Horoskop, Thema: Verstehen, Warengruppe: HC/Astrologie, Fachkategorie: Astrologie, Thema: Orientieren, Text Sprache: ger, Originalsprache: eng, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Chiron Verlag, Verlag: Chiron Verlag, Verlag: Chiron, Länge: 210, Breite: 131, Höhe: 23, Gewicht: 445, Produktform: Kartoniert, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,24,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.